EstontincTerbit 3 menit baca
Cara menekan biaya AI tanpa menurunkan kualitas: pelajaran dari penghematan 68% Cloudflare
Biaya AI code reviewer Cloudflare naik dua kali lipat tanpa perubahan besar, lalu turun 68% setelah dioptimasi. Ke mana uangnya pergi, apa yang memperbaikinya, dan cara menerapkannya.
Bagaimana cara menekan biaya AI? Banyak tim mendapati tagihan AI tumbuh lebih cepat dari pemakaiannya. Pada 19 Oktober 2026, Cloudflare menceritakan hal itu terjadi pada AI code reviewer internal mereka, dan bagaimana mereka menurunkan biaya rata-rata per review sebesar 68%, dari $2,43 menjadi $0,77, sambil memastikan kualitas tetap terjaga.
Artikel ini menjelaskan kenapa biaya AI bisa naik diam-diam, apa yang diubah Cloudflare, dan checklist yang bisa diterapkan di fitur AI apa pun. Kalau masih merencanakan fitur, mulai dari panduan kami tentang menghitung biaya API AI.
Kenapa biaya AI naik diam-diam
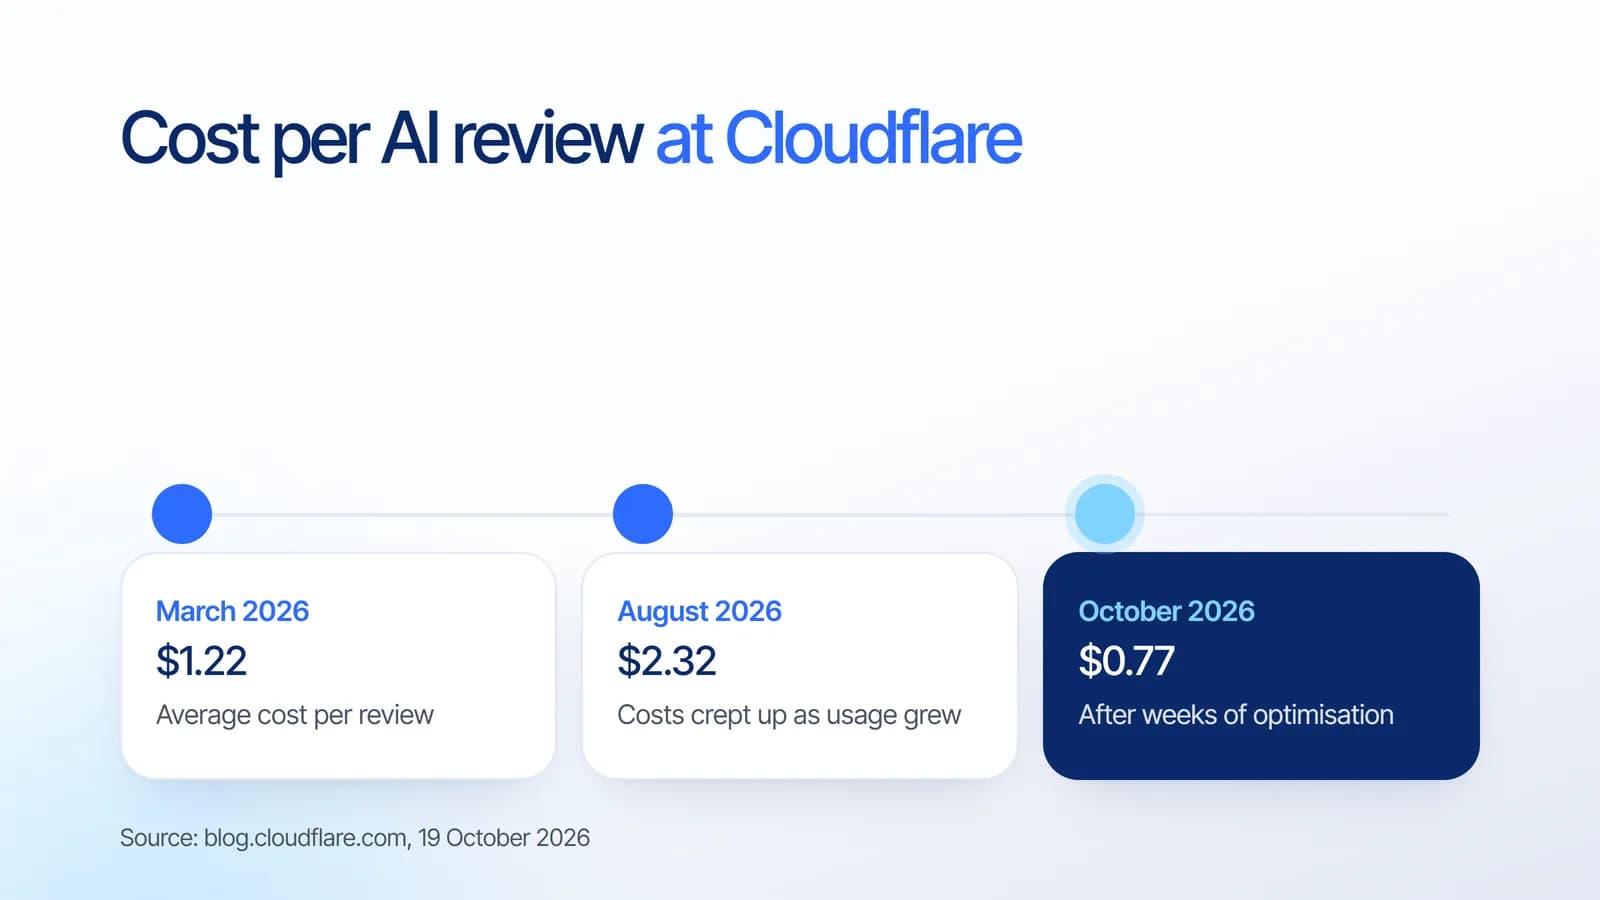
Biaya rata-rata per review Cloudflare naik dari $1,22 pada Maret menjadi $2,32 pada Agustus, tanpa perubahan arsitektur yang berarti. Penjelasan mereka: model makin pintar dan teliti, sehingga agen membaca lebih banyak konteks dan melakukan lebih banyak panggilan. Token per review naik lebih dari tiga kali lipat, dari 0,91 juta menjadi 2,99 juta.
Sebelum dioptimasi, sebagian besar biaya habis untuk konteks yang sudah atau akan dibaca ulang oleh model: cache write sekitar 43% dari biaya, cache read sekitar 34%, dan token output sekitar 23%. Setiap panggilan mengirim seluruh percakapan, jadi biaya bertambah seiring jumlah panggilan dan ukuran konteks.
Apa yang diubah Cloudflare
- Prefix cache yang dipakai bersama. Permintaan pertama tiap sesi hanya menemukan prefix di cache 14% sampai 26% dari waktu, padahal definisi tool dan prompt agennya sama. Menyusun ulang prompt supaya bagian yang sama bisa di-cache sendiri menjadi penghematan terbesar.
- Panggilan lebih sedikit. Memindahkan indeks referensi ke dalam prompt memangkas panggilan salah satu reviewer per run dari 15,9 menjadi 9,6. Menyembunyikan tool yang tidak boleh dipakai sub-reviewer menghapus satu panggilan sia-sia di sebagian besar sesi.
- Satu prefix untuk tiga reviewer. Reviewer kualitas kode, keamanan, dan performa kini mengirim permintaan pertama yang identik, sehingga reviewer berikutnya membaca dari cache.
- Model dan effort dipilih lewat uji. Uji acak menunjukkan model dan tingkat effort mana yang menjaga kualitas sambil memakai lebih sedikit token.
Sekitar 40% penghematan datang dari perubahan kode, sisanya dari pilihan model dan effort. Sejak awal September, cache read per review turun 82%, cache write 54%, dan output 67%. Review yang paling lambat juga membaik: review yang lebih dari lima menit turun dari 37,9% menjadi 0,7%.
Apakah kualitasnya turun?
Cloudflare tidak sekadar berasumsi. Mereka mengecek apakah developer menindaklanjuti temuan, dan meminta model dari dua penyedia berbeda menilai 657 temuan secara buta. Untuk kualitas kode dengan effort tinggi, yang hilang sebagian besar noise: developer menindaklanjuti 59% temuan serius, naik dari 34%. Dengan effort sedang, sebagian temuan nyata hilang, jadi tingkat effort diuji per reviewer, bukan dipangkas serentak.
Checklist biaya AI
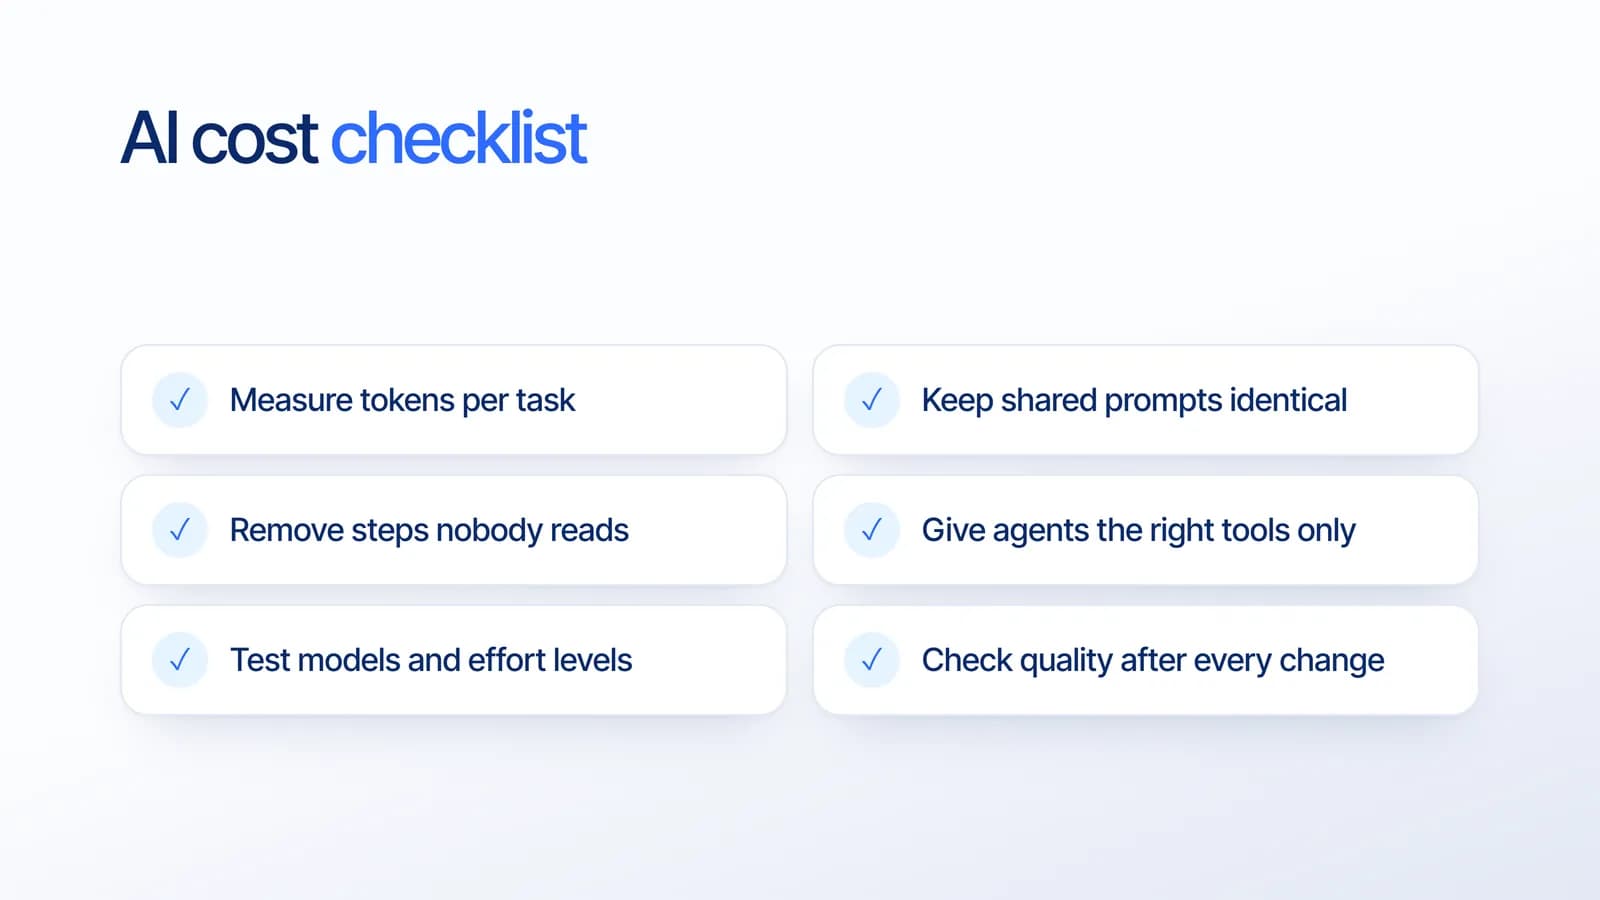
Berdasarkan hasil Cloudflare dan pengalaman proyek kami, kebiasaan berikut menjaga fitur AI tetap terjangkau:
- Ukur token per tugas, dipisah menjadi input, cache read, cache write, dan output.
- Jaga prompt bersama tetap identik dan selalu di awal setiap permintaan, supaya bisa dibaca dari cache.
- Hapus langkah yang tidak dibaca, misalnya ringkasan atau panggilan tool yang hasilnya tidak pernah dipakai.
- Beri agen hanya tool yang dibutuhkan, supaya tidak membuang panggilan untuk tool yang tidak boleh dipakai.
- Uji model dan tingkat effort dengan tugas nyata, bukan asumsi. Panduan kami tentang memilih model AI untuk bisnis membahas pertimbangannya.
- Cek kualitas setiap ada perubahan, dengan sampel hasil nyata, sebelum dirilis.
Artinya untuk bisnismu
Fitur AI bukan biaya sekali bayar. Saat model makin pintar dan pemakaian bertambah, biaya bisa naik dua kali lipat tanpa ada yang sadar. Memperlakukan biaya token seperti biaya server, diukur, ditinjau, dan dioptimasi rutin, menjaga proyek AI tetap menguntungkan tanpa mengorbankan hasil.
Bagaimana Estontinc membantu
Estontinc adalah software house di Malang dengan 100+ proyek dan 50+ klien selama lebih dari enam tahun. Lewat layanan AI development, kami merancang prompt, caching, dan pilihan model untuk fitur AI, lalu menguji kualitasnya. Tim cloud dan DevOps kami menyiapkan monitoring supaya biaya token selalu terlihat.
Tagihan AI-mu terus naik? Ceritakan fitur yang kamu jalankan lewat halaman kontak, dan kami balas dalam 24 jam.
Pertanyaan yang sering diajukan
Kenapa biaya AI terus naik?
Saat model makin pintar, agen cenderung membaca lebih banyak konteks dan melakukan lebih banyak panggilan. Di Cloudflare, token per review naik lebih dari tiga kali lipat antara April dan September. Karena setiap panggilan mengirim seluruh percakapan, biaya ikut naik seiring jumlah panggilan.
Bagaimana Cloudflare memangkas biaya AI 68%?
Cloudflare menyusun ulang prompt supaya bagian yang sama dibaca dari cache, menghapus panggilan dan tool yang tidak perlu, memakai satu prefix untuk tiga reviewer, dan memilih model serta effort lewat uji acak. Sekitar 40% penghematan datang dari perubahan kode, sisanya dari model.
Apakah menekan biaya AI menurunkan kualitas?
Tidak selalu, tapi harus diukur. Cloudflare menemukan bahwa untuk kualitas kode dengan effort tinggi, yang hilang sebagian besar noise dan developer lebih sering menindaklanjuti temuan. Dengan effort sedang, sebagian temuan nyata hilang, jadi setiap perubahan perlu diuji dulu dengan hasil nyata sebelum dirilis.
Apa itu prompt caching?
Prompt caching membuat penyedia AI bisa memakai ulang bagian prompt yang sudah diproses, biasanya dengan harga lebih murah. Cara kerjanya berdasarkan prefix, yaitu isi di awal permintaan, jadi instruksi dan tool yang sama sebaiknya selalu identik dan diletakkan paling awal.
Sumber
Fakta dan angka di artikel ini berasal dari sumber resmi berikut.
- AI
- AI development
- Cloudflare
- Cost